Contexto
Transcribir un audio o video con fidelidad suele implicar pagar un servicio en la nube y entregarle contenido que puede ser sensible. La idea original fue cargar un archivo con drag and drop y obtener su texto en formato Markdown, íntegro y fiel al original.
Objetivo
Validar que una transcripción local, gratuita y privada sea lo bastante fiel para uso real: costo recurrente de 0 USD, fidelidad medida contra un set de evaluación propio y ningún dato fuera del equipo.
Usuarios
Una sola persona que usa la app en su computadora con Windows, sin cuentas ni login. Es una herramienta de uso personal; el servidor solo escucha en 127.0.0.1.
Solución
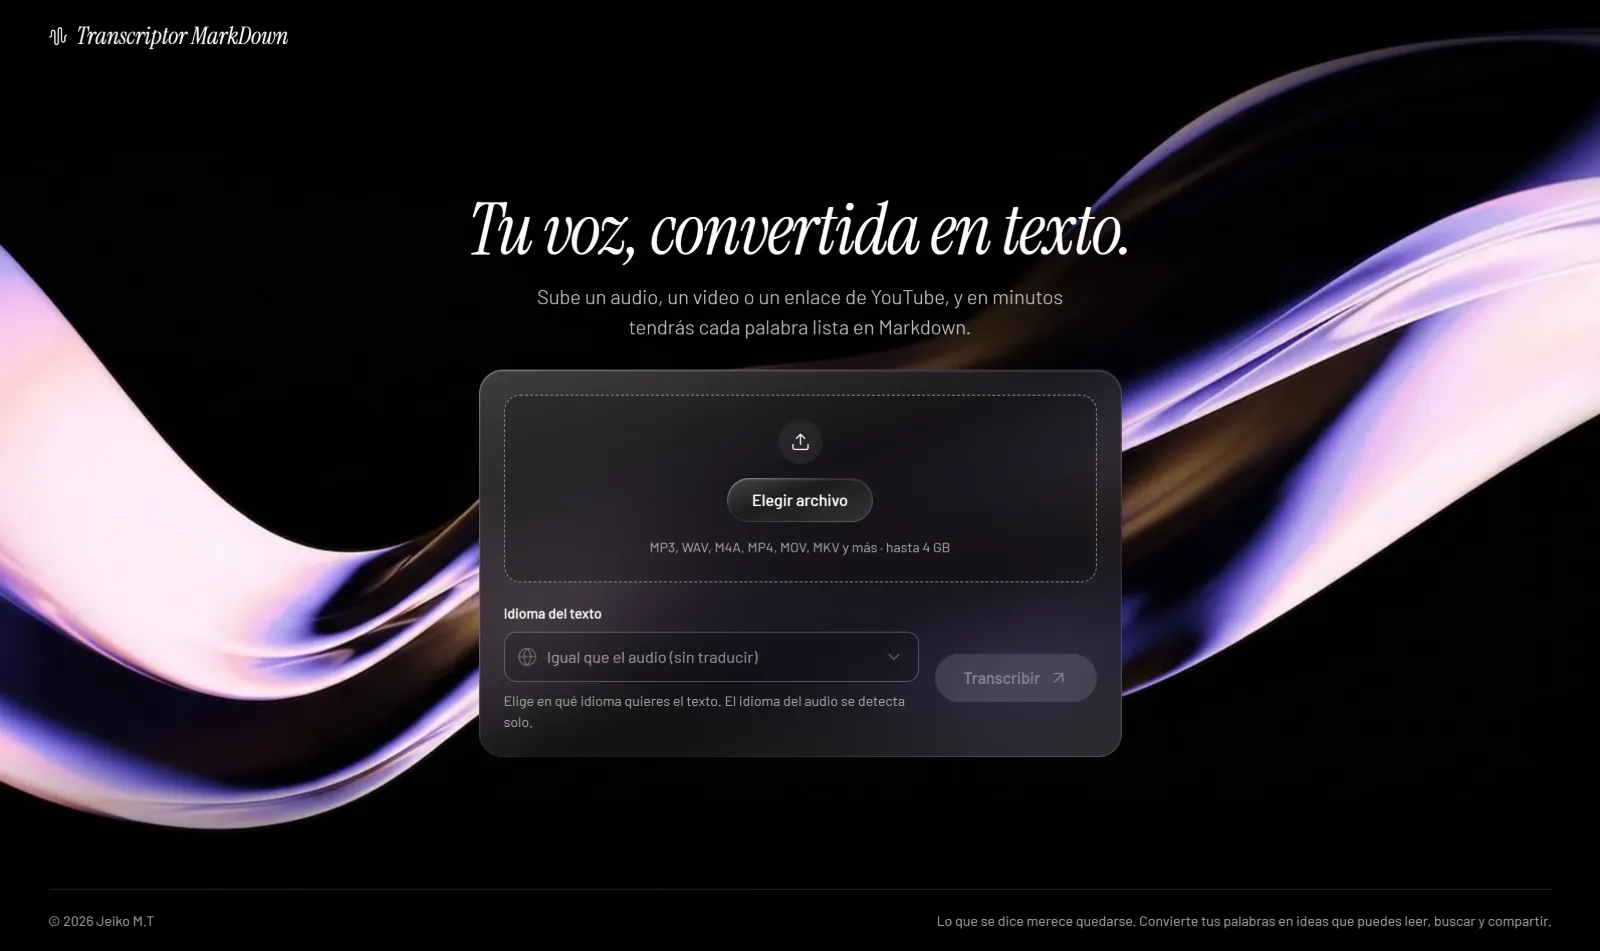
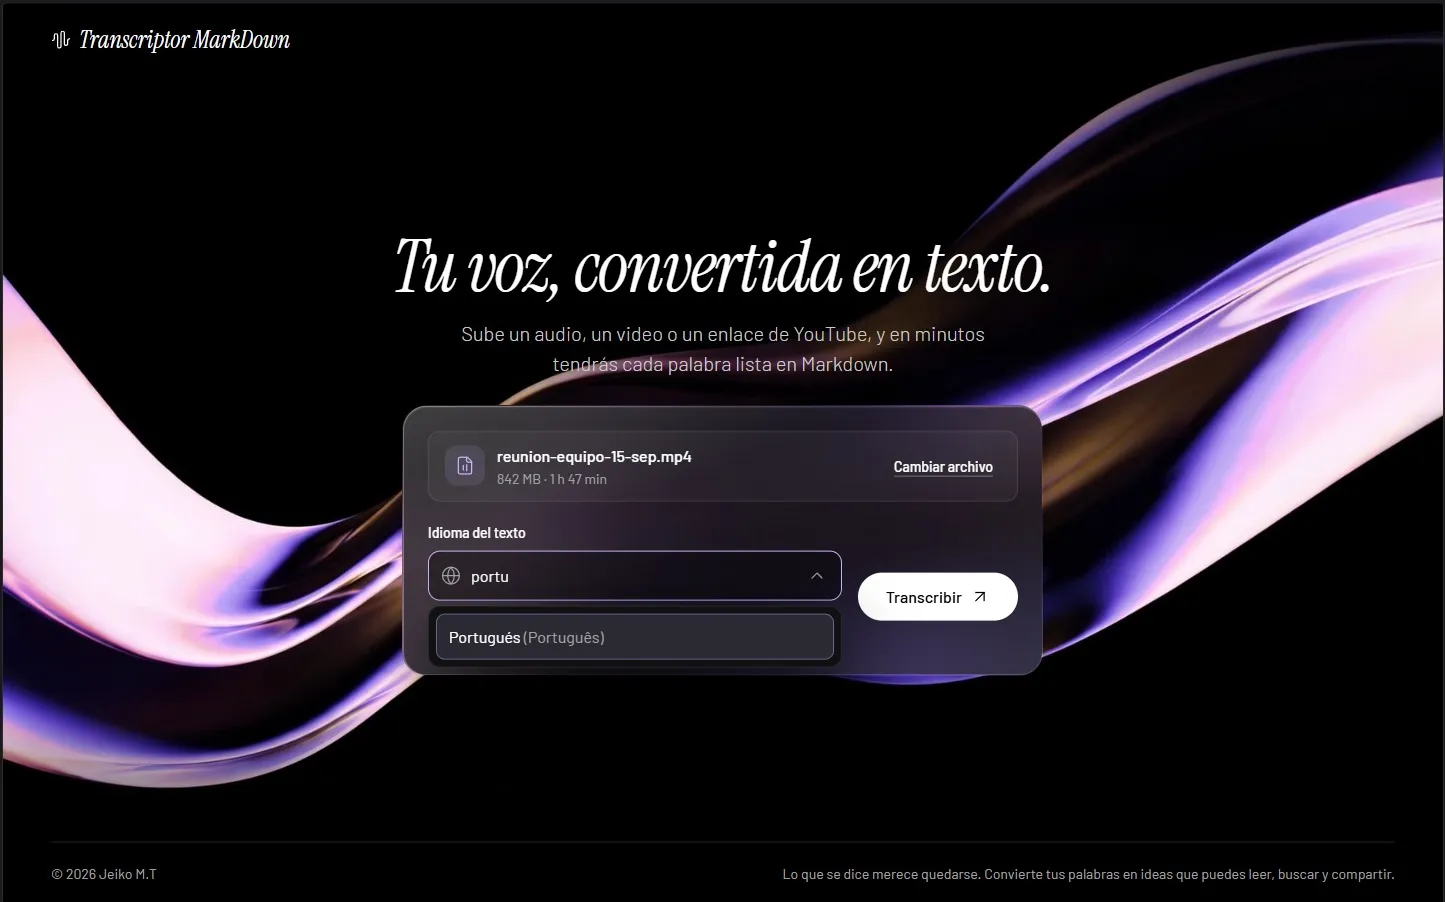
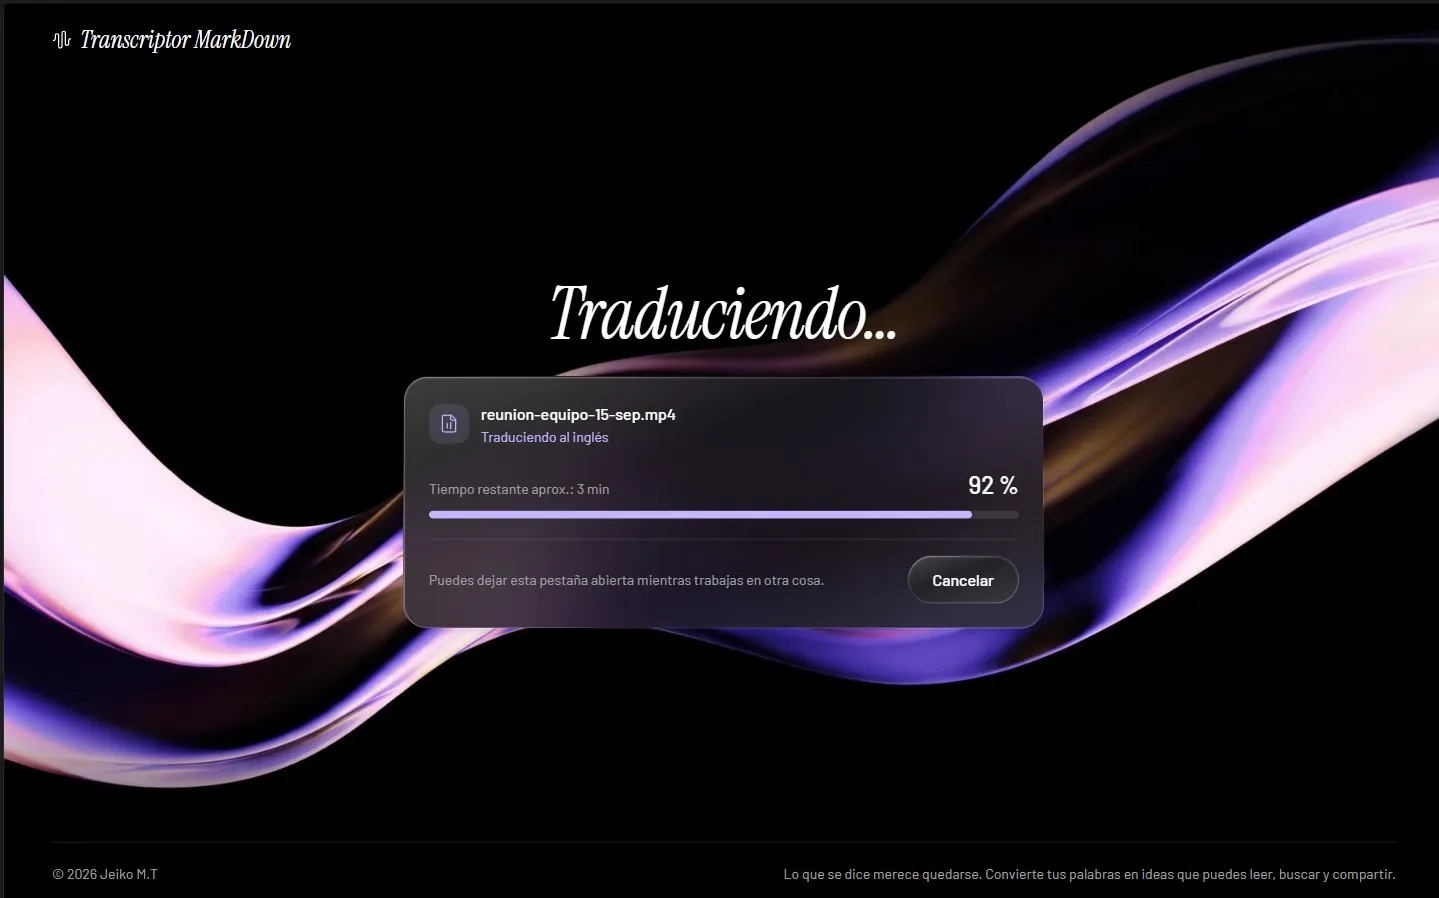
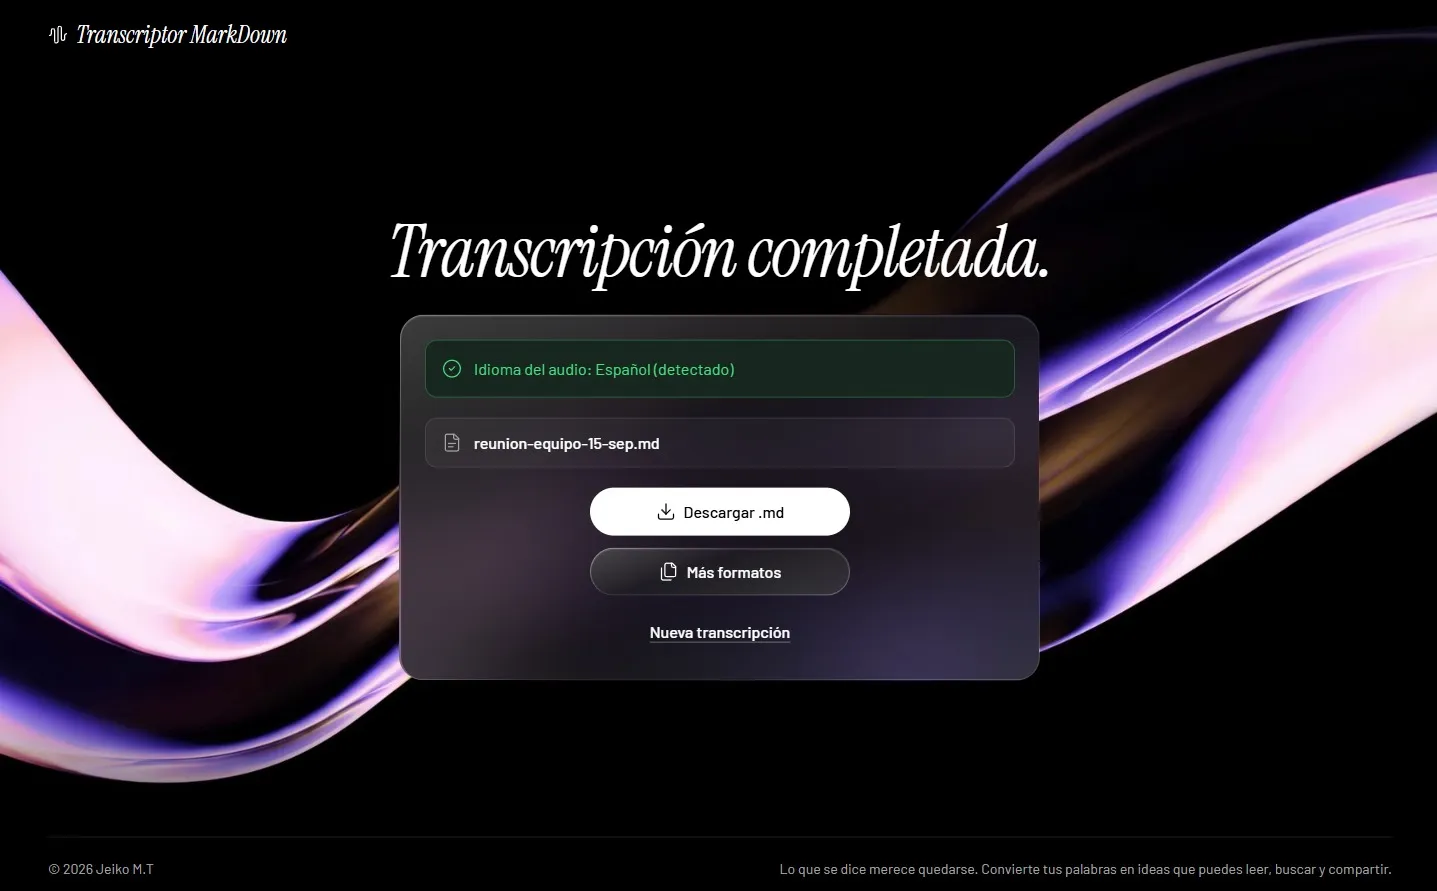
El usuario suelta un audio o video, elige el idioma del texto y pulsa Transcribir. Se muestran el avance y el tiempo restante, y se puede cancelar. Al terminar descarga un .md con solo el texto, en párrafos y sin muletillas, o lo guarda como Word, PDF, HTML o texto desde la ventana nativa Guardar como.
El idioma del audio se detecta siempre solo. Si el usuario elige otro idioma, el texto se traduce de forma local. Los archivos y el resultado se borran al terminar, sin historial.
Arquitectura
Monolito modular: un proceso Python con FastAPI sirve la página estática y la API, y ejecuta la transcripción en un hilo. No hay base de datos, colas ni microservicios, porque es un solo usuario y un trabajo a la vez. El progreso se consulta por polling cada segundo.
Navegador
index.html + app.js
FastAPI
API y estáticos · 127.0.0.1
Gestor de trabajos
En memoria, un trabajo a la vez
ffprobe / ffmpeg
faster-whisper
Post-proceso
NLLB-200
Exportador
Los modelos se descargan una sola vez de Hugging Face; después todo funciona sin conexión.
Modelo de datos
No hay base de datos. El trabajo vive en memoria y los archivos temporales en una carpeta que se vacía al arrancar. Solo se guarda en disco un JSON de calibración con números, sin contenido del usuario.
Job (memoria)
- id
- status
- phase
- progress
Job · archivo
- original_name
- duration_s
- size_bytes
Job · idioma
- detected_language
- target_language
- translated
Job · resultado
- paragraphs
- result_text
- error_code
calibracion.json
- model
- rtf_samples
Idioma (constante)
- code
- name_es
- nllb_code
Tecnologías
Python con FastAPI y uvicorn en el backend; faster-whisper para la transcripción (modelo large-v3-turbo en int8, con procesamiento por lotes); NLLB-200 sobre CTranslate2 para la traducción; ffmpeg y ffprobe para leer y convertir el audio. La exportación usa python-docx y fpdf2 con fuentes Noto. La interfaz es HTML, CSS y JavaScript sin framework, con Instrument Serif y Barlow locales, y pruebas con pytest y jiwer.
Seguridad y privacidad
Ningún dato sale del equipo: solo hay una descarga única de los modelos desde Hugging Face. Se rechazan peticiones de otros orígenes, los nombres de archivo se sanean, ffmpeg se llama sin shell y el texto transcrito nunca se escribe en los logs.
Calidad y pruebas
Pruebas unitarias del post-proceso con cobertura mínima de 80 %, pruebas de integración de la API y un benchmark que mide WER, velocidad y memoria con y sin lotes sobre audios propios. Meta de fidelidad: WER de 10 % o menos con audio claro en español.
Decisiones y dificultades
La limpieza de texto es determinista y solo quita vocalizaciones sin significado de una lista cerrada; ningún modelo de lenguaje reescribe el contenido. El equipo no tiene GPU, así que se eligió large-v3-turbo en int8 y lotes para ganar velocidad sin perder precisión.
La traducción se hace por oraciones y conserva el número de párrafos. Su licencia (CC-BY-NC) permite uso personal; si el producto se comercializa hay que cambiar el traductor.
Resultado
Prototipo en construcción. La especificación va en la versión 1.4 y la interfaz ya está diseñada y aprobada; el desarrollo avanza por fases.
Siguientes mejoras
Fases del roadmap: base del proyecto; motor, lotes y traducción; API de trabajos y exportación; integración de la interfaz; validación con una transcripción real de más de 2 horas.